总结出潜在的规律
就如同上面图2 - 7所展示的例子那样,存在着一种情况表述为“鱼龙混杂”,其中那些未知的图像是由好坏不同的人共同构成的。经过训练了的模型尝试着要把它们组合放置在一起,然而算法有可能是通过进行探索分析,再借助三观之后,从而得出各个不同的人群分类结果。
目前用于无监督学习的前 7 种算法是:
偏最小二乘
模糊的意思
奇异值分解
K-means 聚类
先验的
层次聚类
主成分分析
在神经网络和深度学习中也会有无监督学习的应用。
智能轮式自主移动机器人也会用到监督学习。
2.7.3.3.强化学习
强化机器学习是一种机器学习模型,它类似于监督学习,然而该算法并非运用样本数据来开展训练,此模型借助反复试验不断进行学习,借助奖惩机制,更多成功的结果会使程序得以强化,针对给定问题制订最佳建议或政策,也就是说,如同传统类型的数据分析一样,算法也是经由反复试验去发现数据,进而决定哪些行动会带来更高的回报奖励(reward)。
强化学习含有三个主要构成部分,分别是代理,环境以及动作。代理指的是学习者或者决策者,环境涵盖了代理与之进行交互的全部内容,动作是代理所施行的行为。机器人属于代理。
强化学习会在代理选择动作时发生,此动作要在给定时间里面将预期奖励最大化。当代理于健全的策略框架之内进行工作时,这是最易于达成的。
特点:
决策处理
奖惩机制
学习-行动产出
2.7.3.4小结
由这节内容能够明白,机器学习的类别是多种多样的,这就表明需要具备一定的场景分辨能力。
机器学习的运用,极大地考验着我们的分析能力,这是由于,只有对数据场景拥有清晰的认识,才能够选择合适的机器学习方法。
存在三类学习,它们各自有着优势与劣势,并且这三类学习均可同时处理相同类型的问题,在这种情形下,就需要从更多的角度去对问题予以考量,像成本方面、稳定方面、性能这类方面等等。
笔者总结了一些机器人场景下的模型应用。
机器人防碰撞 强化学习、监督学习
机器人运行模式 识别 监督学习
机器人视觉分类 图像SVM等
机器人IMU 9轴陀螺仪 监督学习
2.7.4 如何决定使用哪种机器学习算法?
存在数十种不一样的算法可用于挑选的情况下,然而并没有哪一种算法能够达成“一劳永逸”的效果。于大量的状况之中,势必要展开反复的试验才能够获取到一个理想的成果。挑选何种方法能够借助一些特性来缩小范围。
想获取什么样的结果,0或1还是具体数值或者其他?
使用的数据大小是多少,大批量或小批量?
使用什么类型的数据,维度、时间序列、图像矩阵?
希望从数据中获得什么样的特征,维度、时间序列、图像矩阵?
对数据认识足够清晰,这些“清晰的认识”将如何使用?
数据量太大,是否选择降维算法提取数据?
一则提示,原始数据之中含有大量的信息,然而面临的挑战在于,要去识别那些重要的模式以及变量。诸如决策树、因子分析、缺失值比还有随机森林等这类降维算法,能够助力您寻找到相关的细节。
2.7.5 机器学习的最佳编程语言是什么?
当前按照受欢迎的程度来讲,这般情形下,Python是最为“得意”的,这得归因于诸多可用的库以及广泛的支持,Python是数据分析与数据挖掘的理想之选,它还支持诸多算法,这些算法用于分类、聚类、回归以及降维,并且它还支持许多机器学习模型这也是事实呀。
如今,名为机器学习的那一门新型科学界别,非常神奇,它正逐步地悄无声息控制人们日常的生活,渗透到从定向广告直至发现癌细胞等各个方面,到处都能看到它的“身影”。
例如,当下流行的框架,pytorch,tensorflow keras,都是借助python来拓展自身影响力范围的。
当然,机器学习的开发语言存在c、c++ ,于机器人终端而言,除开python之外,c/c++无疑是更为适宜的语言,鉴于机器人针对于响应速度具备较高要求,并且c、c++能够达成这些。
2.7.6 机器学习步骤
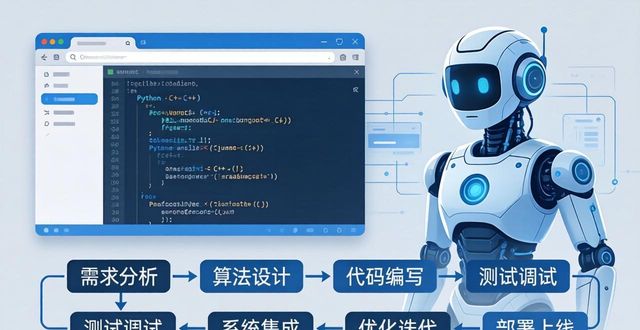
在第2.7,1章节当中,曾被提及过步骤,而于本章节之内,会进行具体的说明,它能够划分成7个主要的步骤:
2.7.6.1 收集数据
数据分为多维序列数据和图片数据、时间序列数据。
例如:
由3个震动传感器采集的数据组成3维的数据。
图片是二维矩阵数据。
声音属于时间序列数据。
必须要收集可靠的数据,这点有着十分重要的意义,如此一来您的机器学习模型才能够寻觅到正确的工作模式。要是存在不正确或者过时的数据,那就会得出错误结果或者预测。
质量好的数据,是相关的,包含少之又少的缺失值,以及重复值,不存在干扰性,也没有随机性,并且能够很好地表示已然存在的标签类别。
数据收集能够采用仿真环境的模式,于这般情形下能够实现干净数据的归集操作,这存在 necessity ,需依照实际环境去展开数据收集工作。鉴于收集数据量庞大,因而须考量其批量处理能力以及自动化能力。
2.7.6.2 准备数据:
取得数据之后,最先要针对数据施行整理,要是属于图片范畴,那就得把不清晰的图片予以删除。能够借助以下方式来开展优化:
均一化。
随机化,把您手握的全部数据汇聚到一块而后进行随机化。这有益于保障数据均匀散布,而且排序不会对学习进程造成影响。
清除数据,以此来删去那些并非需要的数据,还有缺失的值,以及行与列,重复出现的值,进行数据类型的转换等。
可视化的数据能够便于方笔直截了当地去知晓结构,进而去明白各类变量以及所存在的类相互之间的关系。把清理过后的数据划分成两组,一组是训练集,另一组是测试集。训练集乃是您的模型从中获取学习的聚集。测试集是用来在训练之后核查模型的精确程度的。
比如,对于某一数据集,它的文件路径存在着训练集即 train,以及验证集也就是 val,经由 via 标注工具分别生成一个带有区域标注的文件名后缀是 json 的标签文件。
lid@LAPTOP-85KPM8J9:/mnt/e/machineLearn/buildings_datasets$  tree -L 2
.
├── train
│   ├──  0000002_0003951_0000003_0000759.jpg
│   ├──  0004-0143409_p.jpg
│   ├──  0004-0143410_i.jpg
…
│   └──  via_region_data.json
└── val
    ├── P2VBr3KZuYBOF1QA-DIRrQ.jpg
    ├── P3dr3y0NZpnQsTcjIW-x9U.jpg
    ├── P4we3TZeMBwNVD2Q8KyegQ.jpg
     …
    ├── via_region_data.json
可以对数据集存在的形式开展自定义,然而终端是要借助程序去读取的,因而,为了能够更快速地读取数据集,能够依照常见的数据集结构,像pasvoc、minisit之类的。
2.7.6.3 选择模型:
机器学习模型,确定在收集的数据之上、运行机器学习算法而后所得的那个输出。要做出选择,选与手头所面临任务相关的模型,这是关键要点所在呀。多年的时长之中,科学家以及工程师,开发创造出了,适用于语音识别、图像识别、预测、分类这些不同任务情形的各种各样的模型呢。
例如从分类还是预测的角度选择:
如预测房价、预测速度、预测角度等效具体数值之际,需回归类的模型,而非分类的模型,与之对应的激活函数,亦会有各异的选择。
从数据的结构选择模型:
图像数据可以选择卷积网络、声音选择时间序列模型等。
2.7.6.4 训练模型:
机器学习里,训练是最为关键的一步,在那段专门进行训练的进程当中呢,您先前准备好的那些数据会被传递给机器学习模型,目的是让其去查找其中存在的模式,进而实现预测的行为,如此这般就致使模型能够从这些数据里展开学习,最终达成可以完成那一系列任务集合的目标,随着时间持续不断地向前推移,借助训练这个过程,模型在预测环节会日趋变得更加出色。
借助keras或者pytorch现有的训练框架,能够节省好多编码训练模型的时间,此外,训练期间通过matlotlib可视化能够助力分析训练的效果怎样。
例如pytorc通过构建迭代、优化、反向传播构建训练器。
TrainSize,SensorNNData,SensorNNLabels  = PreprocessData()
    print ('Total Epoch %d,epoch TrainSize  %d' %(NumEpochs,TrainSize))
    loss_vals=  []
    for j in range(NumEpochs):#迭代器
        losses = 0
        for i in range(TrainSize):
            input_values =  Variable(SensorNNData[i])
            labels =  Variable(SensorNNLabels[i])
            #print(input_values)
            #print(labels)
            # Forward + Backward + Optimize
            optimizer.zero_grad()#每次训练需要清除梯度
            outputs = net(input_values)#需要训练的网络
            loss = criterion(outputs, labels)
            loss.backward()#反向传播
            optimizer.step()#优化器
            losses += loss.item()#损失函数
2.7.6.5 评估模型:
训练模型后,您必须检查它的性能。
通过在以前看不见的数据上测试模型的性能来完成的。
这个时候测试集就起到作用了,环环相扣。
留意:别运用训练时用过的一样的数据去测试,没办法得到准确的测量结果,由于模型已然使用了数据,且在那里面找到了跟之前相同的模式。
评估模型能够借助多次训练,设置不一样的参数,进而获得不同的结果,以此来展开分析对比。
2.7.6.6 参数调优:
在创建了模型并对其进行评估之后,查看一下是不是能够借助任何手段来提升它的准确性,这操作是经由对模型当中所存在的参数予以调整而达成的的,那些构成部分乃是程序员一般情况下会去确定的模型里的变量,于您所设定的参数的特定数值状况下,精度将会处于最大值,参数调整所指的便是去探寻到这些数值。
2.7.6.7 做出预测
最后,您可以使用您的模型对看不见的数据进行准确的预测。







